 Lunote
コピー&ペーストの隠れたコスト
汎用チャットを開くたびに、まず「コンテキストを再構築」する必要がある。現在の段落を貼り、2 つ目のファイルを貼り、それらの関係を説明する。 モデルが回答を返す頃には、すでに思考の半分を終えている——それでも、添付し忘れた 5 つのノートを無視した返答が返ってくるかもしれない。
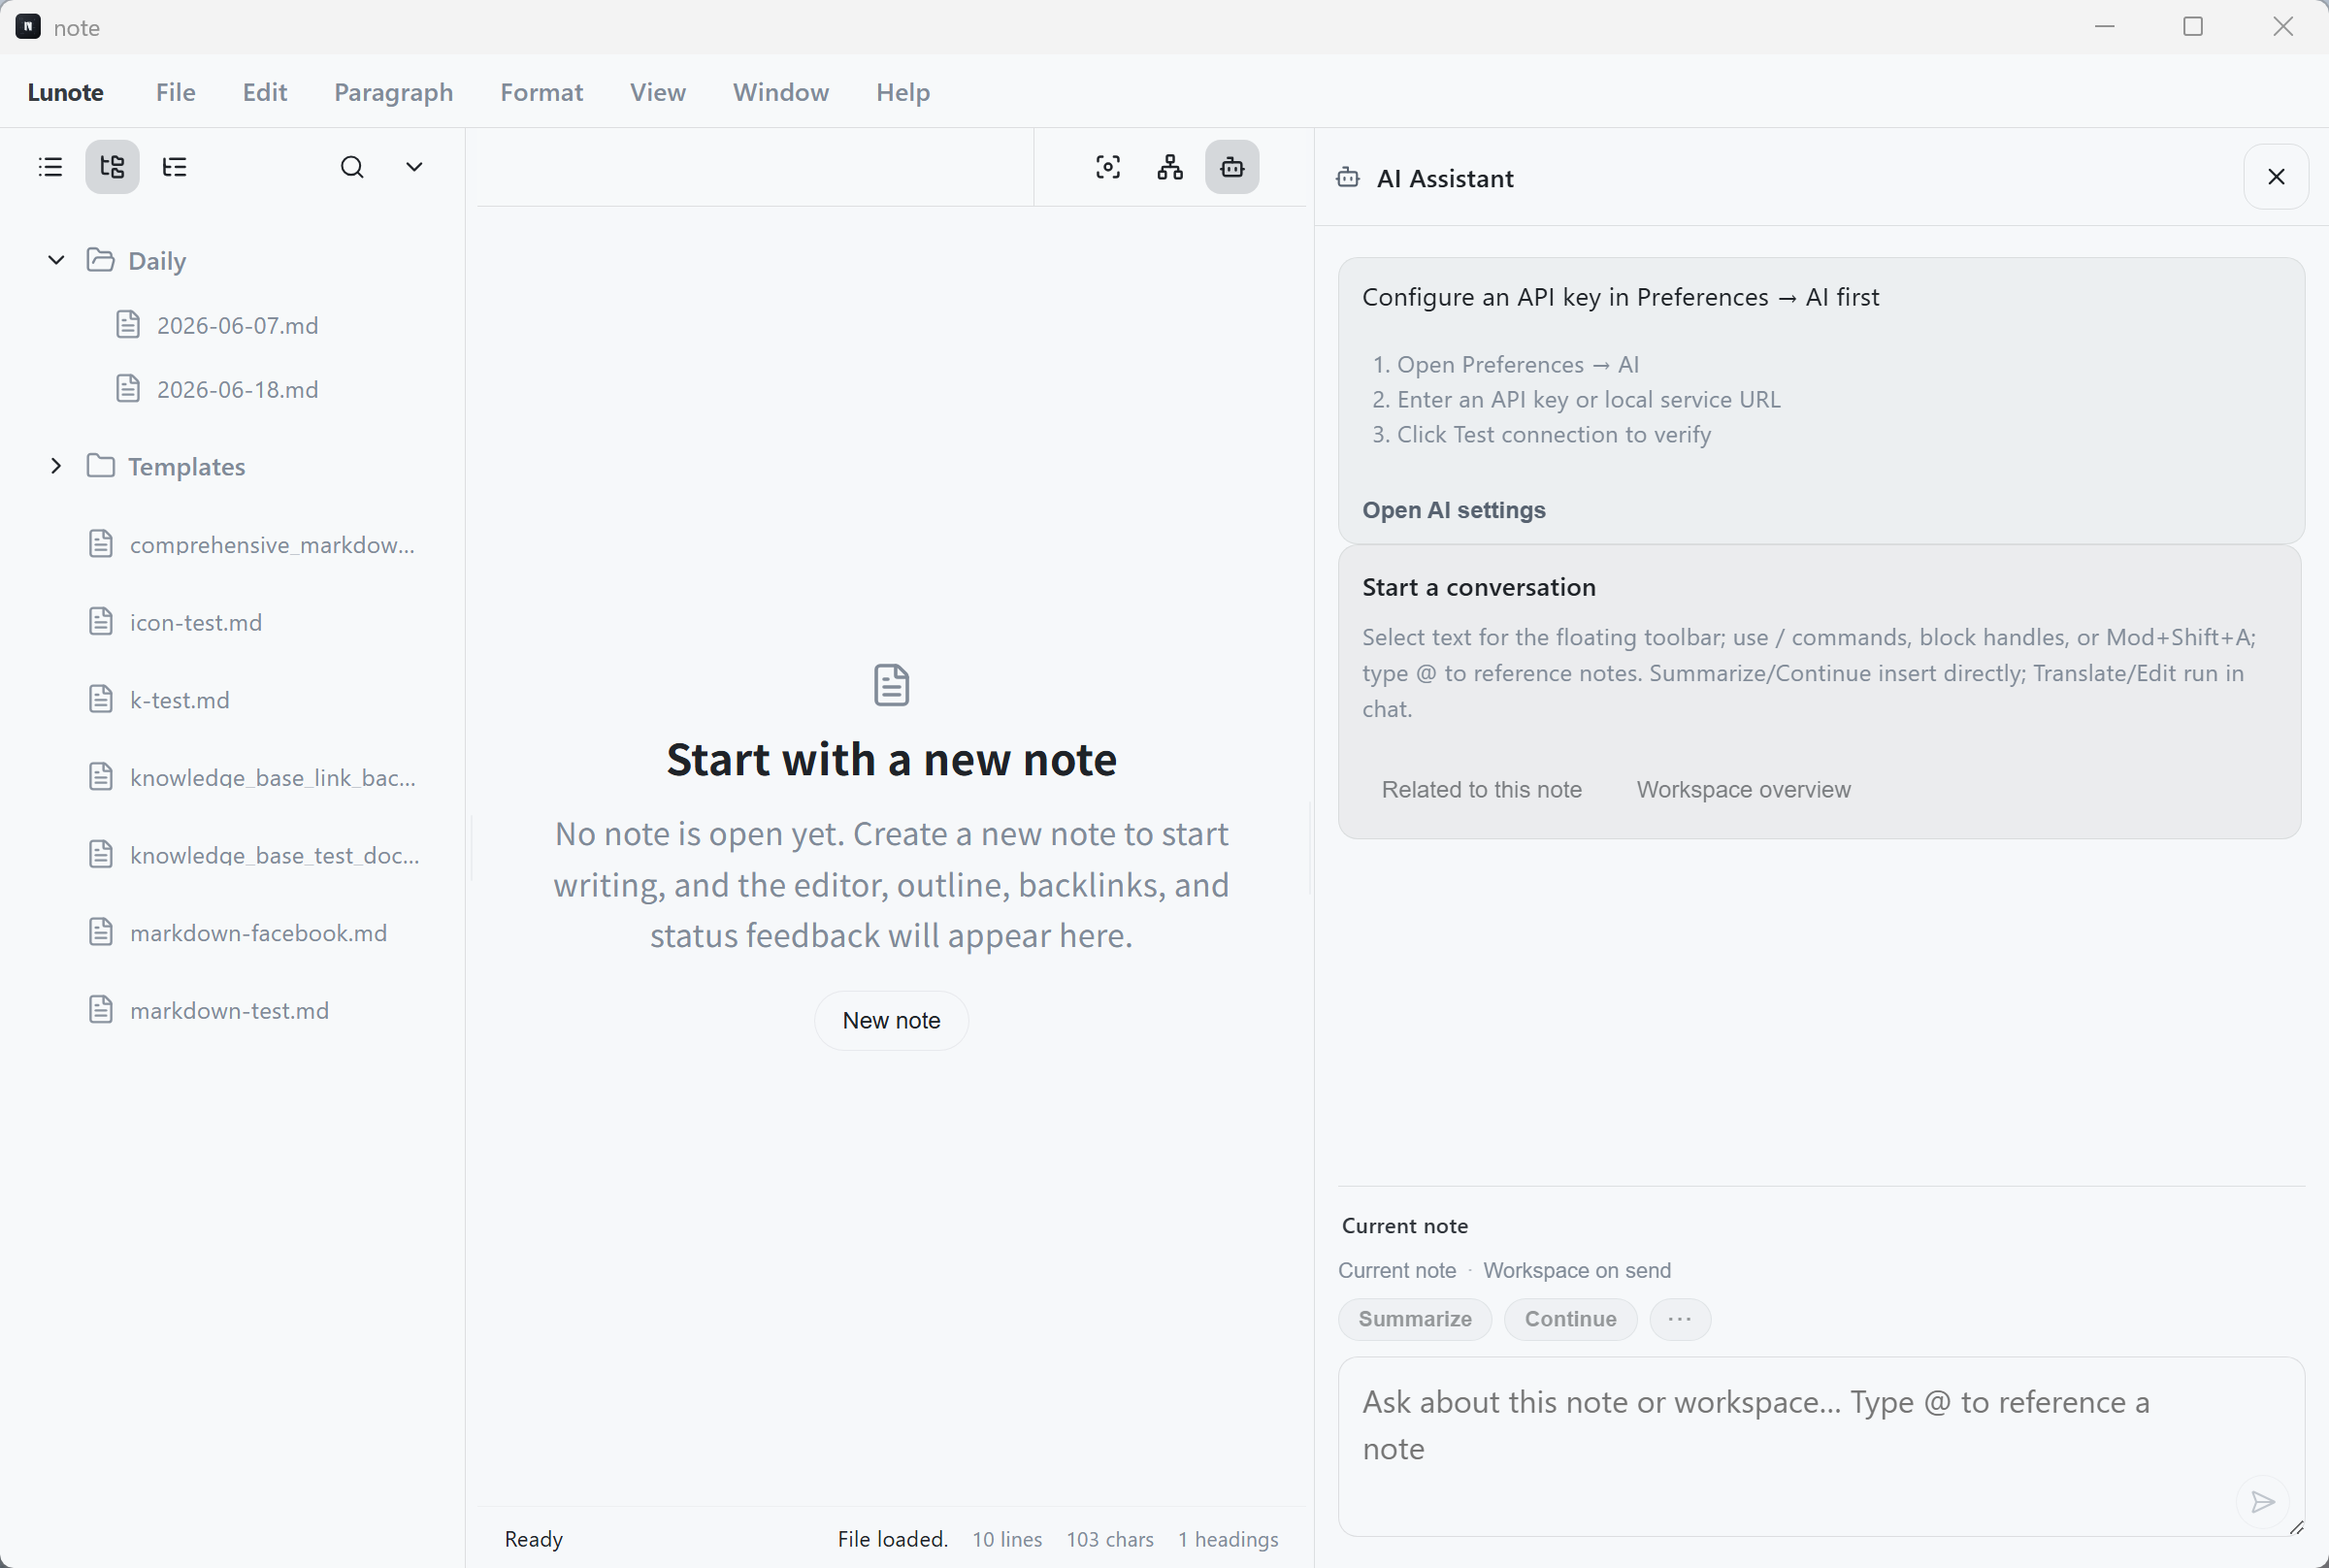
ワークスペース認識型 AI はこのステップを省く。アシスタントはライブラリ内の構造化されたソースから情報を読み取る:
現在開いているノート、テキストの選択範囲、[[双方向リンク]] で関連付けられた隣接ノート、そしてオプションのワークスペース検索結果。
その場で質問すれば、モデルは同僚と肩を並べて作業するときと同じ文脈で回答する。
「ワークスペース認識型」とは具体的に何か
- 現在のノート — 要約、アウトライン、書き換えは編集中のドキュメント全体に基づく。古い貼り付け断片ではない。
- 選択範囲 — テキストをハイライトするだけで、全文を変更せずに推敲、翻訳、拡張ができる。
- リンクされた隣接ノート — 発信側の双方向リンクと受信側のバックリンクから関連概念を自動的に取り込む。
- ライブラリ内検索 — 質問が複数のトピックにまたがるとき、ワークスペースの他の場所から関連する断片を引き出す。
コンテキストとは「より多くの Token を詰め込む」ことではなく、「正しい Token を詰め込む」こと——知識グラフから選び出すのであり、ハードディスク全体を流し込むのではない。
なぜローカルファーストのノートと相性が良いのか
クラウドノートブックは AI にアカウント内のすべてのコンテンツを読ませることがデフォルトになりがちだ。 Lunote のようなローカルファーストツールは逆のアプローチを取る。Markdown はディスクに残り、自分の API Key を使い、能動的にトリガーしたコンテキストだけがプロバイダーに送信される。
これは業務ノート、顧客情報、まだアップロードする準備ができていない未完成のアイデアにとって特に重要だ。 AI はすでに持っているファイルの加速器になる——他人のデータベースに移行させる理由ではない。
開発者がよく使う具体的なシナリオ
障害の振り返り
Runbook と過去の障害記録にリンクされた [[incident-2026-06-postgres]] を開く。
これらの隣接ノートに基づいて振り返りのアウトラインを起草するようアシスタントに頼む——3 つのブラウザタブを手動で組み立てる必要はない。
アーキテクチャドキュメント
ADR を書いているとき、「代替案」セクションを選択し、リンクされた意思決定ノートに基づいて反論を提示するようアシスタントに頼む。 バックリンクは、どのサービスが記録中の案に依存しているかを示す。
学習ノート
読書中に概念をメモする。ノートが散らかってきたら、リンクされた前提ノートを尊重した構造化された要約を生成するようアシスタントに頼む。
ワークスペース AI + 知識グラフ = 複利効果
孤立したドキュメント上の AI は一度きりの回答しか出せない。 リンクされたライブラリ上の AI は、グラフが成長するにつれて使うほど良くなる——隣接ノートには数ヶ月前に書いた定義、判断、命名規則が含まれているからだ。
これがチャットのおもちゃと思考環境の違いだ。モデルは白紙ではなく、内部 Wiki を読んだペアプログラミングの相手のように感じられる。